2026.10.09
02|系统监控和可观测性有什么不同?
目录
《可观测性工程》学习讲义 · 第 02 讲
系统告警响了,却没人知道为什么,这是很多团队的真实处境。监控与可观测性并不是两种互相替代的工具,而是发现问题和解释问题的两层能力。
监控回答“是否正常”
监控依靠预先定义的指标和阈值,例如错误率超过 5%、延迟超过 10 秒。它对已知问题很有效,但只能发现团队提前想到并设置了规则的异常。
可观测性则保留更丰富的执行上下文,使工程师可以在故障发生后继续提问:哪些用户受影响?从哪个版本开始?异常集中在哪一步?
一个简单案例
报告 Agent 的失败率突然从 2% 升到 15%。监控告警说明系统异常,但不能证明“模型变差了”。进一步按版本和步骤查询后发现,失败都集中在 search-tool v2,返回字段从 items 改成了 results,Harness 仍按旧结构解析。
这次故障中:
- 监控发现失败率升高;
- Trace 找到失败步骤;
- 工具版本和返回 Schema 解释了根因。
现实挑战:模型还是Harness
Agent 输出不稳定时,最常见的误判是立刻更换模型。正确做法是建立多个假设:
| 假设 | 证据 |
|---|---|
| 模型能力问题 | 固定工具结果和流程后,不同运行仍推理失败 |
| Harness问题 | 失败集中在循环、终止或状态传递节点 |
| 工具问题 | 失败与工具版本、字段缺失或超时高度相关 |
| 上下文问题 | 失败任务出现截断或关键信息缺失 |
现象—假设—证据—判断
现象:报告缺少搜索结果。假设包括模型忽略数据、工具未返回数据、Harness 解析失败。证据显示工具调用成功且原始结果完整,但解析后的状态为空。判断:主要原因是 Harness 与工具契约不兼容,而不是模型能力不足。
如何协作
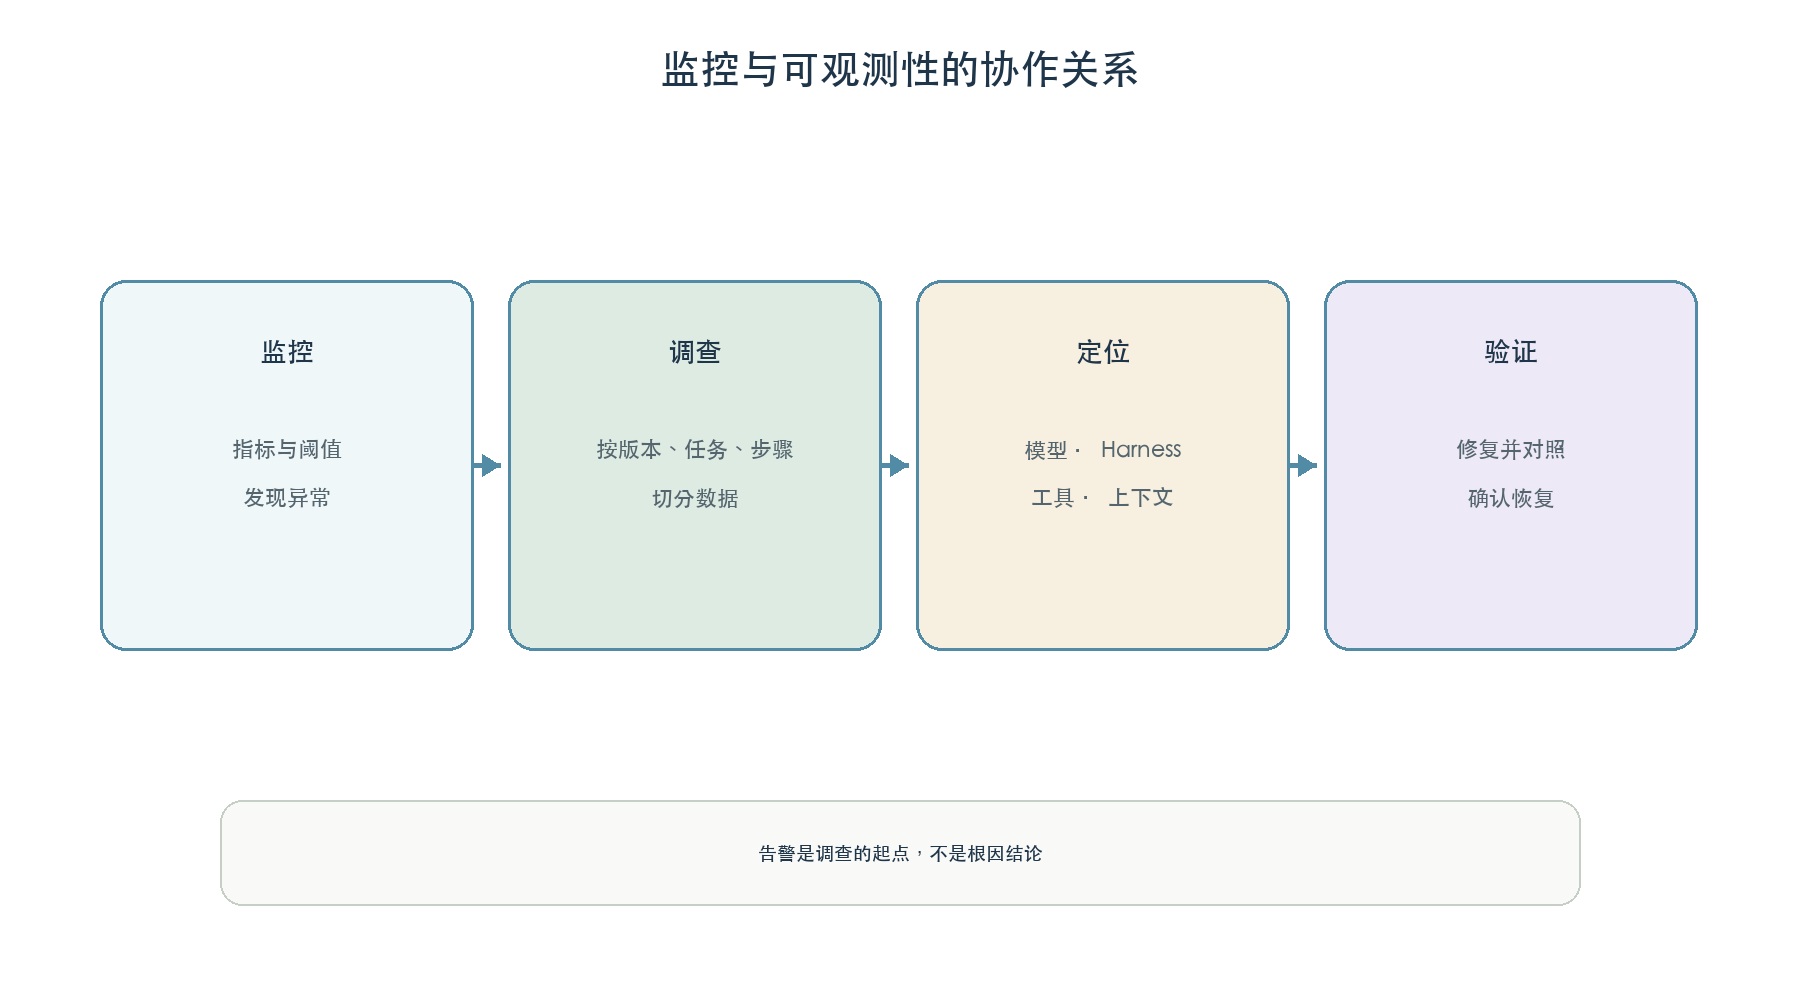
监控发现异常 → 可观测性查询上下文 → 定位根因 → 修复并验证
监控让团队尽快知道“出事了”,可观测性让团队知道“事情为什么发生”。成熟系统需要两者配合,而不是用越来越多的仪表盘代替调查能力。
小结
监控面向已知问题,可观测性面向未知问题。对于 Agent,告警只是调查起点;模型、Harness、工具、接口、上下文和 Memory 都应通过证据逐层排除。
可观测性工程系列:上一篇:01|可观测性工程概要:从系统输出理解内部状态 · 下一篇:03|遥测的基础数据模型
原文:LandX
相关文章
- 06|可观测性工程中的语义管理《可观测性工程》学习讲义 · 第 06 讲 数据格式一致,不代表数据含义一致。一个团队写 model,另一个写 llmname,第三个写 p…
- 11|构建 Agent Runtime 的实时可观测性《可观测性工程》延伸讲义 · 第 11 讲 传统可观测性经常用于事后排障,但 Agent Runtime 还需要在任务执行过程中感知风险:工…
- 08|基数、采样与成本《可观测性工程》学习讲义 · 第 08 讲 可观测性希望保留细节,但每一条 Span、每一个属性和每一天的保留时间都会产生成本。工程设计的目…
- 07|Agent 的可观测性和诊断框架《可观测性工程》学习讲义 · 第 07 讲 模型调用只是 Agent 执行的一部分。真正决定结果的,还有规划、上下文组装、Memory 检索…