2026.10.09
07|Agent 的可观测性和诊断框架
目录
《可观测性工程》学习讲义 · 第 07 讲
模型调用只是 Agent 执行的一部分。真正决定结果的,还有规划、上下文组装、Memory 检索、工具调用、重试和终止条件。只观测 LLM API,会错过大部分行为链路。
一条完整的Agent Trace
Agent Run
├── build-context
├── retrieve-memory
├── plan
├── model-call
├── execute-tool
├── evaluate-result
└── final-response
根 Span 表示一次任务,子 Span 表示关键步骤。模型调用记录模型、Token、停止原因和耗时;工具调用记录工具、Schema 版本和执行状态;Memory 检索记录查询、候选数量和得分。
一个简单案例
客服 Agent 明明“记得”用户上周的退款请求,却给出了过期答案。Trace 显示模型正常遵循了上下文,问题出在 Memory:检索把半年前的相似记录排在最新记录之前。
如果只保存最终 Prompt,我们可能认为模型理解能力差;记录检索候选和排序后,才能看到错误信息是怎样进入上下文的。
现实挑战:鲁棒性问题来自哪里
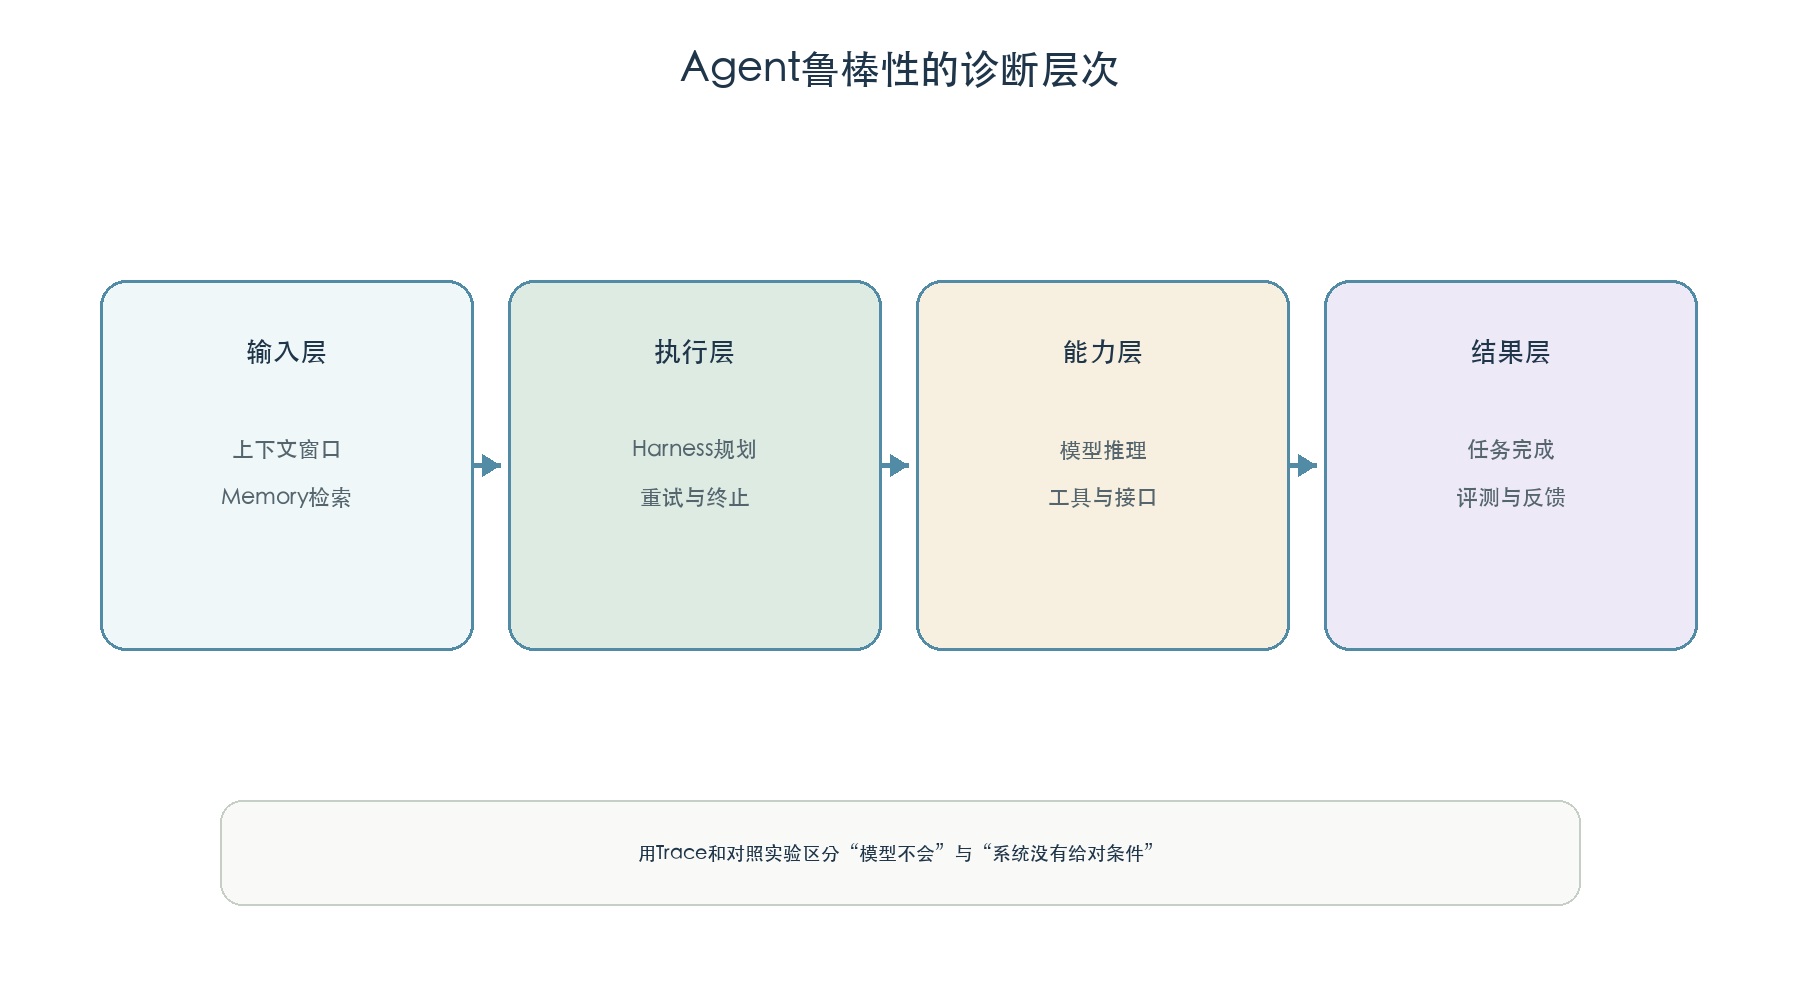
Agent 偶发失败可能来自六个层次:模型能力、Harness、工具契约、LLM 接口适配、上下文管理和 Memory 检索。必须做对照实验,而不是依据最终答案猜测。
现象—假设—证据—判断
现象:长对话中工具调用参数经常缺失。假设包括模型结构化输出不稳定、供应商接口适配错误、上下文截断。证据显示短对话稳定,失败任务都接近窗口上限,系统指令和工具定义位于被截断区域。判断:主要原因是上下文窗口管理,而不是工具调用能力不足。
修复可以包括保留系统指令、压缩历史消息、设置 Token 预算,并对截断位置进行遥测。
质量也要被观测
技术成功不等于任务成功。HTTP 200、模型正常返回、工具无报错,最终答案仍可能没有解决用户问题。因此还要记录完成状态、评测结果、用户采纳、人工接管和后续纠正。
小结
Agent 可观测性的对象是一段决策与执行过程。只有把模型、Harness、工具、上下文和 Memory 放进同一条 Trace,才能区分“模型不会”与“系统没有给模型正确条件”。
可观测性工程系列:上一篇:06|可观测性工程中的语义管理 · 下一篇:08|基数、采样与成本
原文:LandX
相关文章
- 02|系统监控和可观测性有什么不同?《可观测性工程》学习讲义 · 第 02 讲 系统告警响了,却没人知道为什么,这是很多团队的真实处境。监控与可观测性并不是两种互相替代的工具,…
- 06|可观测性工程中的语义管理《可观测性工程》学习讲义 · 第 06 讲 数据格式一致,不代表数据含义一致。一个团队写 model,另一个写 llmname,第三个写 p…
- 11|构建 Agent Runtime 的实时可观测性《可观测性工程》延伸讲义 · 第 11 讲 传统可观测性经常用于事后排障,但 Agent Runtime 还需要在任务执行过程中感知风险:工…
- 08|基数、采样与成本《可观测性工程》学习讲义 · 第 08 讲 可观测性希望保留细节,但每一条 Span、每一个属性和每一天的保留时间都会产生成本。工程设计的目…