2026.10.09
10|可观测性是评估工程(Eval.)的基础
目录
《可观测性工程》延伸讲义 · 第 10 讲
Agent 产品很难只靠上线前测试保证质量。输入不断变化,模型具有不确定性,工具和知识也持续更新。Evaluation Engineering(评估工程)要做的,是把“这个 Agent 好不好”变成可以持续测量、比较和改进的工程问题。
可观测性正是它的数据基础。
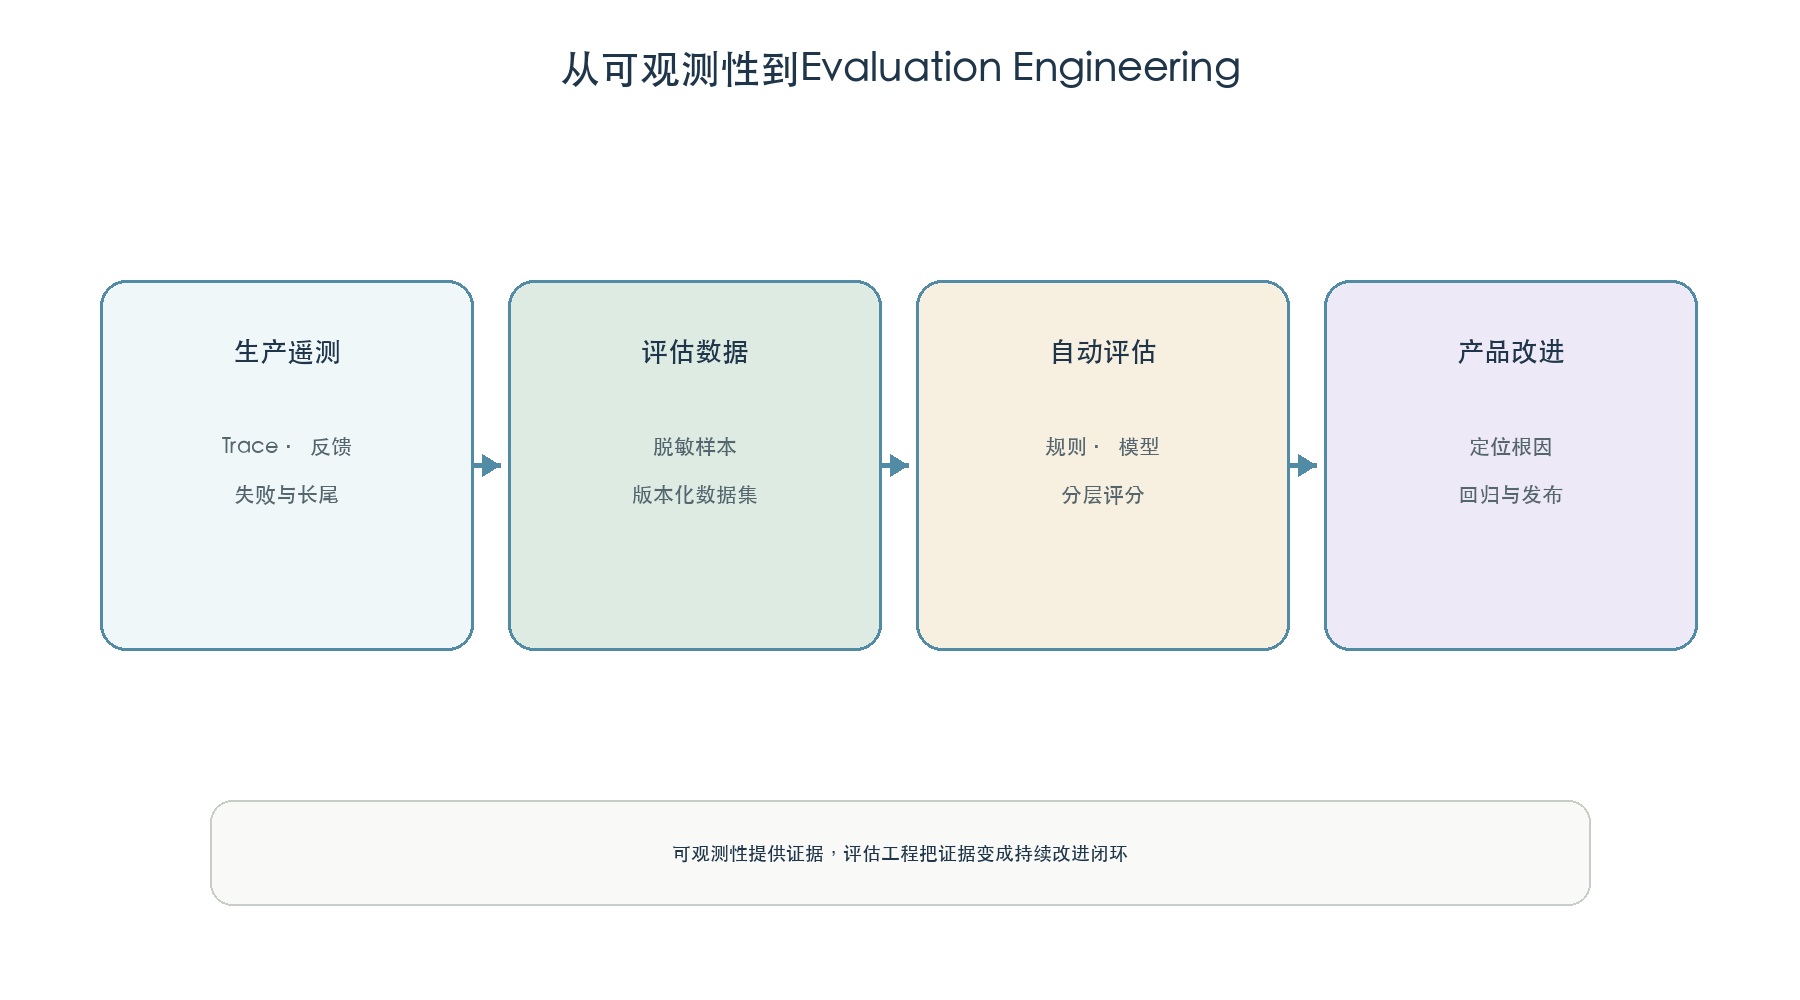
从一次Trace到一个评估样本
一次完整的 Agent Trace 记录了用户目标、上下文、规划步骤、模型调用、工具结果、最终答案和用户反馈。这些数据经过脱敏和筛选后,可以转化为评估样本。
生产Trace → 样本集 → 自动评估 → 失败分类 → 改进 → 回归验证
没有可观测性,评估往往只能看到最终输入和输出;有了执行过程,才能判断错误发生在检索、规划、工具、模型还是结果组装阶段。
一个简单案例
报告 Agent 的最终答案遗漏了一项销售数据。只评估答案,会得到“不完整”这一结果。查看 Trace 后发现,搜索工具返回了正确数据,但 Harness 在合并多页结果时漏掉了最后一页。
于是评估可以进一步拆分:工具召回是否完整、Harness 是否正确组装、答案是否忠于证据。这样的评分才会指向可执行的改进。
现实挑战:评估分数提高,产品却没有变好
原因可能是评估集过于简单、生产分布已经变化、LLM Judge 偏好某种文风,或者新版本对测试集产生了过拟合。
现象—假设—证据—判断
现象:离线完整性得分从 0.82 提升到 0.91,但用户重试率没有下降。假设包括评估指标与用户目标不一致、生产样本分布变化、评分器失真。证据显示评估集主要是单工具任务,而生产失败集中在多工具长任务。判断:评估集代表性不足,不是产品已经得到有效改善。
应从生产 Trace 持续抽取失败、长尾和人工接管案例,补充到版本化评估集中。
评估也必须可观测
每次评分应记录评估器名称与版本、评分维度、分数、解释、输入样本版本和运行时间。否则评分变化可能只是评估器升级造成的。
自动评估适合扩大覆盖,人类评审负责校准标准和处理高风险任务。二者都需要与真实用户反馈对齐。
小结
可观测性让 Agent 的行为成为可分析的数据,评估工程把这些数据变成改进产品的反馈循环。真正有价值的评估,不只给最终答案打分,还能指出失败发生在哪一层,以及下一步应该改什么。
可观测性工程系列:上一篇:09|Agent 可观测性参考架构 · 下一篇:11|构建 Agent Runtime 的实时可观测性
原文:LandX
相关文章
- 02|系统监控和可观测性有什么不同?《可观测性工程》学习讲义 · 第 02 讲 系统告警响了,却没人知道为什么,这是很多团队的真实处境。监控与可观测性并不是两种互相替代的工具,…
- 06|可观测性工程中的语义管理《可观测性工程》学习讲义 · 第 06 讲 数据格式一致,不代表数据含义一致。一个团队写 model,另一个写 llmname,第三个写 p…
- 11|构建 Agent Runtime 的实时可观测性《可观测性工程》延伸讲义 · 第 11 讲 传统可观测性经常用于事后排障,但 Agent Runtime 还需要在任务执行过程中感知风险:工…
- 08|基数、采样与成本《可观测性工程》学习讲义 · 第 08 讲 可观测性希望保留细节,但每一条 Span、每一个属性和每一天的保留时间都会产生成本。工程设计的目…