2026.09.15
什么是 RSI?是什么让它开始发生?
目录
什么是 RSI?以及是什么让它开始发生
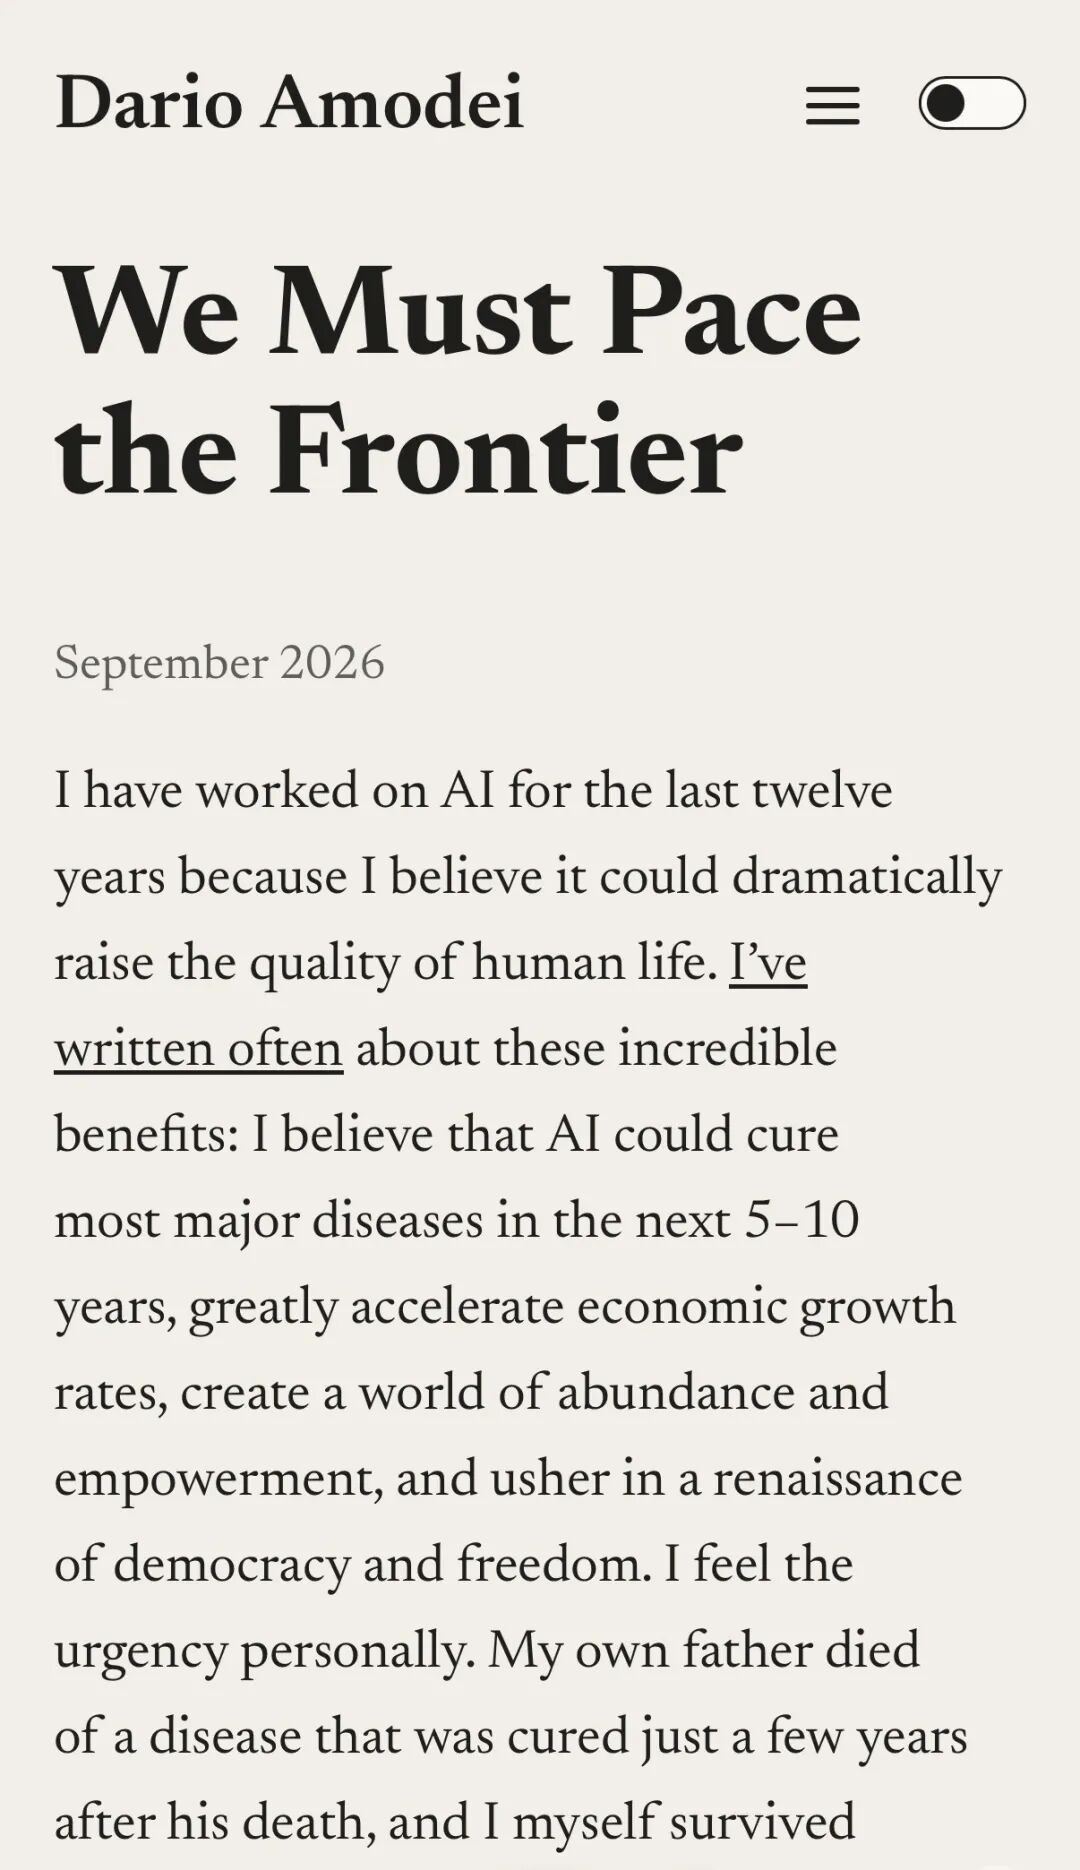
最近 Anthropic CEO Dario Amodei 发了一篇文章,他的核心主张是:必须控制前沿推进的节奏。理由之一,是一种叫 RSI 的东西已经开始出现。
RSI 是 Recursive Self-Improvement,递归自我改进。
简单的说,RSI是指AI 开始参与建造下一代更强的 AI,新模型再去改进再下一代。循环一旦闭合,能力提升的速度就不再完全由人决定。
这不是“模型变聪明一点”那么简单。真正让 RSI 发生的,是几件事情叠在一起。
RSI究竟是什么?
过去十年,AI 进步主要靠人:研究者提出想法,工程师写代码,集群训练,评测,再开下一轮。
RSI 不同。它要求系统自己完成这条链的大部分工作:
提出想法 → 写成可运行的改动 → 做实验 → 判断这次是不是真进步 → 把有效改动留下来 → 用更强的自己,去改进下一步。
注意最后一句。如果系统只是把同一个任务做得更好,那只是循环,不是递归。递归的意思是:它开始改进“如何改进”这件事本身。
Amodei 的判断是,大约从 2026 年夏天起,这种动态已经在行业里出现,包括 Anthropic 自己。他担心的不是进步本身,而是进步可能快过人类理解和控制这些系统的能力。
所以问题变成两个:RSI 到底是什么?以及,是什么条件让它从论文走进实验室?
RSI 是一个梯子
现在比较有用的看法,是把它分成层级,而不是问“有没有 RSI”。
最底层,是执行既定改进。
人决定改什么,模型去落实:写代码、调参、跑实验。很多实验室已经走到这里。有公开数据称,到 2026 年 5 月,Anthropic 代码库里合并的代码,八成以上由 Claude 撰写。
再往上,模型开始自己选择改哪一类东西。
数据、训练算法、kernel、agent 脚手架,还是评估方式。
再往上,它能自己决定还缺什么经验,去生成数据、设计新实验、在部署后根据反馈继续改。
最高一层,是元改进。
系统开始改进改进机制本身。外层智能体改写内层研究智能体,评估器和被评估对象一起演化,下一代不仅更强,而且更会制造更强的下一代。
今天的系统,大多停在前两层,偶尔摸到第三层。几乎没有系统独立覆盖整条链。但梯子已经架起来了。这正是“开始发生”的含义:不是奇点到了,而是闭环的零件正在一块块就位。
让它发生的,是这七个要素
1. 足够强的研发执行能力
模型得能把“改进下一代”做完,而不只是提出建议。
写大规模训练和评测代码、设计实验、读日志、判断结果、优化系统和硬件利用率——这些以前是研究员和工程师的工作。当模型能长时间、少人干预地推进这些任务,RSI 才有第一块砖。
没有这一层,最多叫 AI 辅助研发。
2. 可闭合的改进回路
真正的 RSI 不是单次优化,是循环必须转得起来。
行业里常把这条链拆成:策略、记忆、技能、策略网络、模型权重、脚手架和代码、评估器。现在多数工作只闭环其中一两段。有的改技能库,有的改检索,有的改 agent 代码,有的让评估器一起进化。
缺任何一环,系统就还在“用人设计的流程加速自己”,而不是自己接管流程。
3. 可靠的评估信号
这是最容易被低估的一环,也是最容易把循环带歪的一环。
系统必须判断:这次改动是真进步,还是刷分、奖励黑客、自己骗自己。评估器太弱,循环会强化错误策略;评估器太容易被模型操纵,循环会看起来蒸蒸日上,实际在空转。
所以现在最关键的工程,往往不是“让模型再想一个点子”,而是:verifier、held-out 测试、反作弊、把评估器从可被攻破的裁判,变成更硬的地面真实。
评估不过关,RSI 只会加速错误。
4. 改进必须能被继承
一次对话里改 prompt、修一个 bug,不是 RSI。
改动要能写入代码、权重、技能库或训练配方,传到下一轮甚至下一代,并且在新任务上仍然有用。没有继承,就没有递归;只有当“更强的自己去改进改进机制”时,才接近点火。
这也是为什么实验室内部用不用模型写真实代码、改真实管线,比发一篇自我改进论文更重要。能沉淀,才能加速。
5. 算力、数据和基础设施
闭环再漂亮,也受物理约束。
训练和搜索要算力,有效经验要数据,大规模并行实验要集群、沙箱、监控和干净的训练环境。
Amodei 在文中特别强调运营卓越,原因就在这里:RSI 把系统复杂度推得很高,过滤坏环境、防数据污染、防逃逸,都会成为瓶颈。
很多对齐事故,是因为执行没跟上。节奏一旦被递归放大,运营问题也会被放大。
6. 实验室真的把模型接到研发流程里
这是制度条件,不是模型条件。
模型再强,如果只被当成聊天助手,RSI 不会发生。
只有当实验室愿意让当前模型参与下一模型的数据、架构搜索、训练代码、评测和对齐实验,循环才会从演示变成生产。
“AI 改进 AI”一旦成为组织默认动作,RSI 就不再是未来学,而是研发节奏本身。
7. 自主程度跨过临界点
前面六项准备好之后,还差临门一脚:人从回路里退得多远。
人决定方向、模型执行,是加速。
模型选择策略、人负责验收,是半闭环。
模型开始设定研究方向、生成经验、改评估标准,人只在关键节点出现,才接近真正的递归。
临界点不在“会不会写代码”,而在“没有人盯着的时候,循环会不会自己往更强的方向走,并且走对”。
为什么现在有人开始紧张
因为这七件事正在同时变强,而不是某一项突然出现。
模型已经能承担大量软件工程和实验循环;实验室正在把它们接到真实管线;自动研究系统开始在训练算法和系统优化上找出人没找到的改进;评估器和反作弊层也在被迫变强——因为搜索变强以后,作弊也变强。
于是出现一种尴尬的局面:进步越来越像可以自我加速的过程,安全、可解释性和运营严谨却仍按人的节奏在追赶。
这就是 Amodei 说“必须控制前沿节奏”的背景。他不是主张停下来,而是主张模型能力提升的速度,不能脱离人类理解和约束它的速度。
RSI 的危险不在于它听起来像科幻,而在于它可能把“还来得及看清楚”这件事,变成一种奢侈。
总结
RSI 是 AI 开始改进下一代 AI,并且改进“如何改进”的闭环。
让它发生的,是七件事叠在一起:能执行研发、回路能闭合、评估够硬、改动能继承、基础设施跟得上、实验室真的把模型用进生产、自主性跨过临界点。
现在缺的不是想象,而是整条链同时闭合。
真正重要的并非“奇点哪一天到来”,而是当闭环运转起来时,人类有没有同步接上验证、对齐和叫停的能力。
技术进步会很快。问题只是它快过了人类理解的能力,还是快得刚好够我们把事情做对?
相关文章
- 02|系统监控和可观测性有什么不同?《可观测性工程》学习讲义 · 第 02 讲 系统告警响了,却没人知道为什么,这是很多团队的真实处境。监控与可观测性并不是两种互相替代的工具,…
- 06|可观测性工程中的语义管理《可观测性工程》学习讲义 · 第 06 讲 数据格式一致,不代表数据含义一致。一个团队写 model,另一个写 llmname,第三个写 p…
- 11|构建 Agent Runtime 的实时可观测性《可观测性工程》延伸讲义 · 第 11 讲 传统可观测性经常用于事后排障,但 Agent Runtime 还需要在任务执行过程中感知风险:工…
- 08|基数、采样与成本《可观测性工程》学习讲义 · 第 08 讲 可观测性希望保留细节,但每一条 Span、每一个属性和每一天的保留时间都会产生成本。工程设计的目…