2026.09.29
专题|Agent 软件中可观测性设计:维度与基数
目录
学习笔记|《可观测性工程》
一、为什么 Agent 更难观测
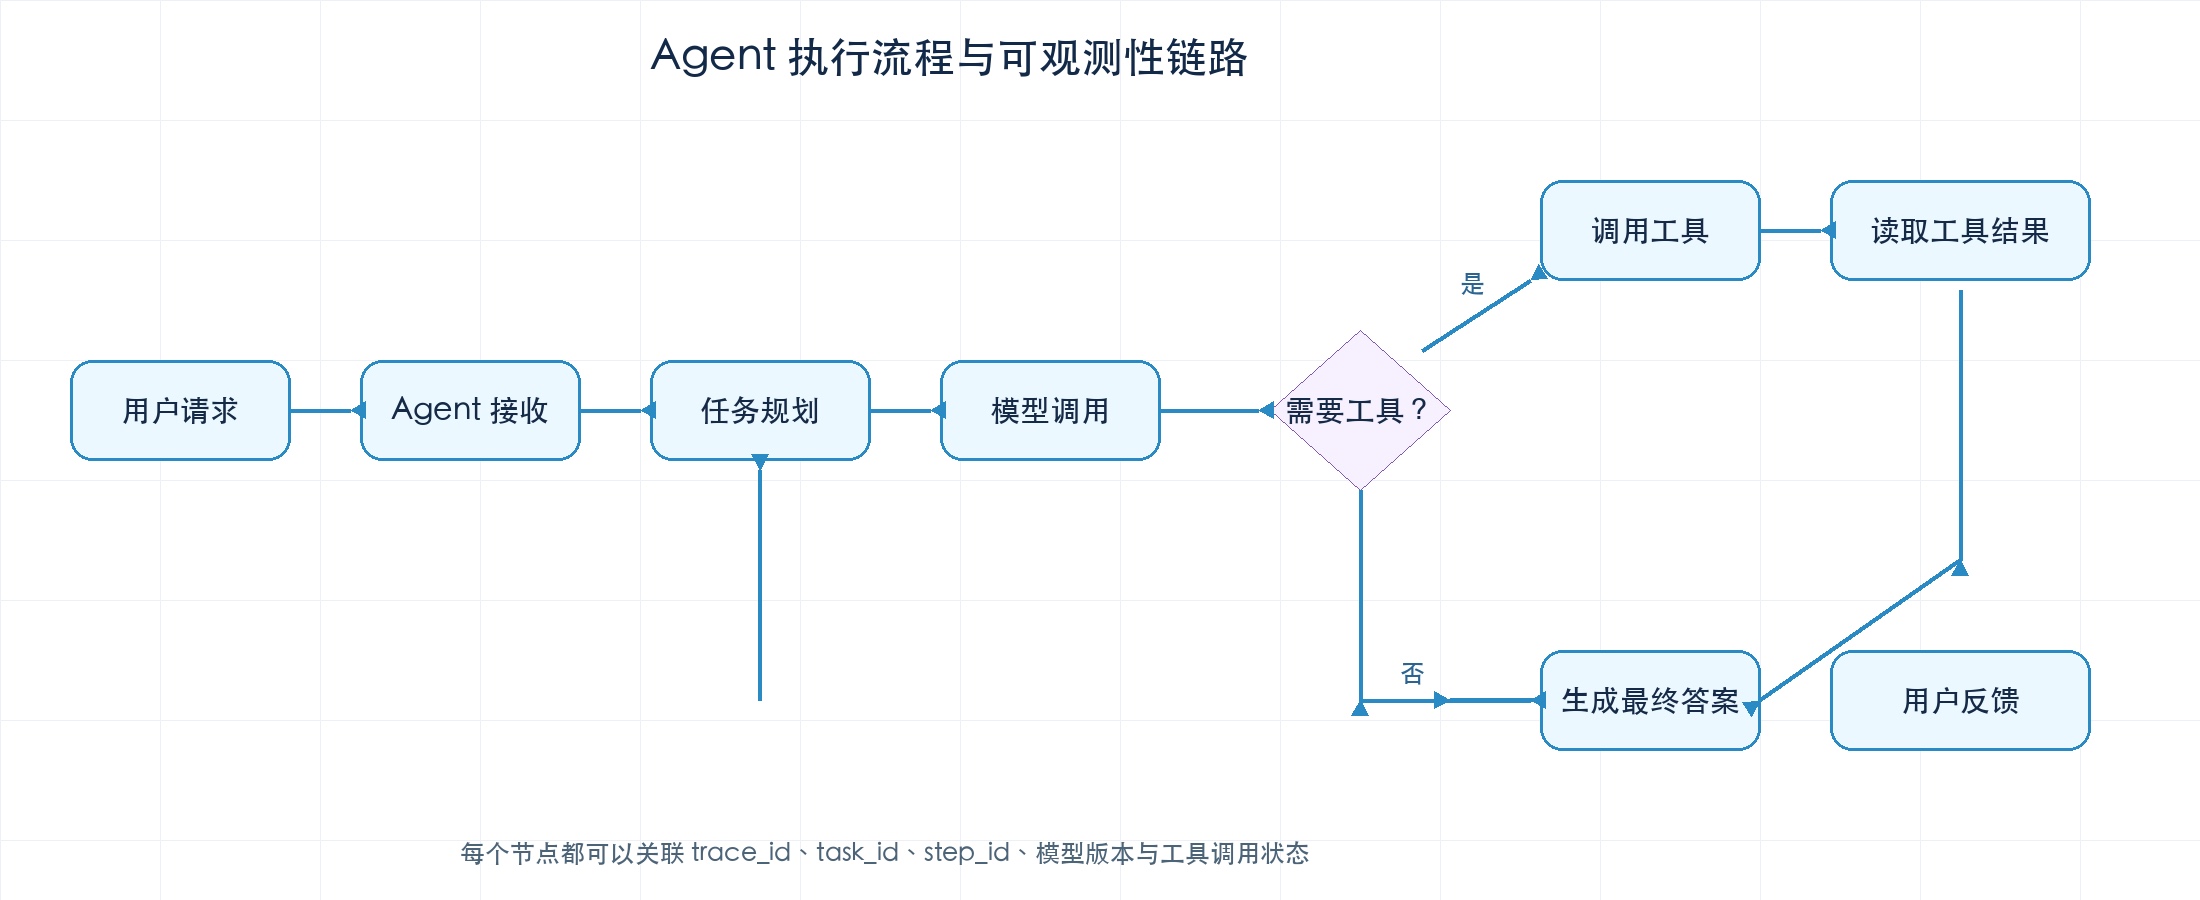
普通 Web 服务的一次请求通常是“请求—处理—响应”,而 Agent 的一次运行往往包含任务规划、模型调用、工具调用、结果读取、重试和最终回答。一次提问可能经历多轮模型调用和多个工具调用,最终答案出了问题,原因未必在最后一步。
因此,Agent 的可观测性不能只看成功率和响应时间,还要回答:它为什么这样规划?经过了哪些步骤?调用了哪些工具?哪一步最慢?哪里发生了重试?最终是否真正解决了用户问题?
二、维度:观察数据的角度
维度可以理解为观察数据的角度,或者切分数据的字段。例如一条工具调用记录中,Agent 名称、工具名称、环境和状态都是维度。
有了这些维度,我们可以追问:哪个 Agent 的工具调用最慢?生产环境和测试环境的失败率是否不同?哪个工具最容易超时?某个版本发布后失败率是否上升?
没有维度,数据只能告诉我们“出了问题”;有了维度,数据才能解释“问题发生在哪里”。
Agent 中常见的维度包括:
| 类型 | 典型维度 |
|---|---|
| 请求 | 用户、租户、入口、任务类型、环境、地区 |
| Agent | 名称、版本、提示词版本、工作流版本 |
| 执行 | 当前步骤、父步骤、规划节点、循环次数、重试次数 |
| 模型 | 模型名称、供应商、版本、输入输出 Token、停止原因 |
| 工具 | 工具名称、版本、参数类型、依赖服务、返回状态 |
| 结果 | 是否完成、是否转人工、用户是否采纳、质量评分 |
这些维度共同构成 Agent 的“观察坐标系”。
三、基数:一个维度有多少种取值
基数指一个维度中不同取值的数量。
status只有成功、失败、超时几种值,是低基数;tool_name可能有几十种值,是中等基数;user_id可能有几百万种值,是高基数;task_id、step_id、trace_id几乎每次都不同,是极高基数。
可以这样记:
维度是“从哪个角度看”,基数是“这个角度有多少种具体情况”。
基数还会发生组合。假设系统中有 8 个 Agent、10 个工具、5 个环境、20 个任务类型和 100 个版本组合,理论上就可能产生 80 万种组合。维度越多,组合空间扩大得越快,这就是“基数爆炸”。
四、高基数不是坏事
传统指标系统往往把每种标签组合存成一条时间序列,因此高基数会增加存储、索引和查询压力。如果把 user_id 和 task_id 都放进指标标签,时间序列很快会膨胀。
但排查 Agent 的单次异常时,task_id、run_id、step_id 和 tool_call_id 往往是最重要的信息。关键不是拒绝高基数,而是把它放到合适的数据载体中。
| 数据类型 | 适合的维度 | 主要用途 |
|---|---|---|
| 指标 | Agent 名称、环境、状态、工具名 | 趋势、告警、容量分析 |
| Trace | 任务 ID、运行 ID、步骤 ID | 还原一次完整执行 |
| 结构化事件 | 规划节点、参数类型、错误原因 | 分析行为模式 |
| 详细记录 | 输入输出、检索结果、模型响应 | 质量分析和问题复盘 |
低基数维度适合放进指标,高基数维度适合放进事件和 Trace。原始输入、输出和工具参数则应放在受控的详细记录中,并进行脱敏、截断或哈希处理。
五、最值得保留的高基数维度
task_id 与 run_id
task_id 表示一个用户任务,run_id 表示一次具体执行。任务失败后,可以沿着它们查看完整过程:规划步骤、模型调用、工具调用、重试和最终响应。
step_id 与 parent_step_id
Agent 经常出现嵌套调用和分支执行。step_id 标识当前步骤,parent_step_id 还原步骤关系,可以帮助定位哪个规划节点引发了大量工具调用,或者哪个分支最容易失败。
tool_call_id
同一个工具可能在一次任务中被调用多次。仅记录工具名不够,还应记录每次调用的 ID、开始时间、结束时间和结果状态。
prompt_version 与 model_version
Agent 的行为变化经常来自提示词或模型版本,而不是业务代码。因此这两个版本字段应成为稳定的观测维度,否则质量下降时只能凭感觉猜测。
六、避免维度设计失控
第一,先问这个维度能帮助回答什么问题。如果一个字段从来不会参与筛选、聚合或定位,就不必放进所有指标。
第二,区分分类字段和唯一标识。tool_name 适合回答“哪个工具失败最多”,tool_call_id 适合回答“这一次调用为什么失败”。两者都要保留,但不应以同一种方式处理。
第三,控制敏感信息。用户输入、手机号、内部文档内容和工具原始参数,可能同时具有极高基数和较高敏感性。应保存必要摘要,对敏感字段脱敏,限制长文本长度,控制访问权限,并明确保存期限。
七、一个实用的三层观测模型
第一层是服务指标,回答“系统整体怎么样”,例如运行总量、失败率、延迟、Token 消耗和工具失败率。
第二层是执行 Trace,回答“这一次发生了什么”,包括 trace_id、task_id、run_id、step_id、agent_version、prompt_version、model_name 和 tool_name。
第三层是结构化事件,回答“为什么会这样”,例如规划创建、模型调用、工具选择、工具返回、护栏触发、步骤重试、人工接管和任务完成。
三层数据配合起来,才能同时满足监控、排障和质量分析。
结语
Agent 的可观测性,本质上是在记录它如何理解任务、如何做出选择,以及如何一步步完成工作。
维度让我们拥有观察角度,基数决定这些角度有多细。低基数维度适合做整体统计,高基数维度适合还原单次过程。成熟的设计不是把所有字段都放进指标,也不是为了控制成本而丢掉细节,而是根据不同数据类型安排合适的承载方式。
对于 Agent,最重要的观测对象不是“请求成功率”本身,而是:一次任务由谁发起、经过了哪些步骤、调用了哪些模型和工具、在哪一步发生偏差,以及最终是否真正解决了问题。
配套资料

原文:LandX
相关文章
- 02|系统监控和可观测性有什么不同?《可观测性工程》学习讲义 · 第 02 讲 系统告警响了,却没人知道为什么,这是很多团队的真实处境。监控与可观测性并不是两种互相替代的工具,…
- 06|可观测性工程中的语义管理《可观测性工程》学习讲义 · 第 06 讲 数据格式一致,不代表数据含义一致。一个团队写 model,另一个写 llmname,第三个写 p…
- 11|构建 Agent Runtime 的实时可观测性《可观测性工程》延伸讲义 · 第 11 讲 传统可观测性经常用于事后排障,但 Agent Runtime 还需要在任务执行过程中感知风险:工…
- 08|基数、采样与成本《可观测性工程》学习讲义 · 第 08 讲 可观测性希望保留细节,但每一条 Span、每一个属性和每一天的保留时间都会产生成本。工程设计的目…